



如何针对不同目标选择 AI 视频工作流程
 受众反馈是另一个需要发布数据来回答的问题。
TL;DR
我发现图片生视频最适合让产品照片动起来,文生视频适合在没有现成视觉素材时探索创意,而视频生视频适合给现有素材换风格。对于社交帖子和广告,我会根据需要一个镜头还是完整序列来选择。Pollo AI是一个不错的起点,因为它把这些选项整合在一起,包括用于完整视频的智能体工作流。
3步选择AI视频工作流
第1步:确定观众需要看到什么
在写提示词之前,我会先问这条视频应该让观众获得什么。
如果是产品展示,我可能希望他们注意到饮品的外观。如果是广告,我需要给他们一个尝试的理由。这会影响我加入的镜头、节奏和信息量。
我会用四个问题来缩小任务范围:
- 产品展示:哪些产品细节需要突出?
- 社交视频:开场有什么值得看下去的点?
- 概念探索:应该传达什么想法或氛围?
- 广告:观众接下来应该理解什么并做什么?
我还会判断一个镜头是否足够完成任务。一个会动的产品图对于商品页面可能就够了。广告通常需要更多上下文,还要有明确结尾。
第2步:从你已有的素材开始
一张有用的照片或片段可以让我省去从零重建场景的时间。
- 我有清晰的图片:我会从图片生视频开始。图片先确定主体和构图。我的提示词重点放在“什么要动”。
- 我有想法但没有图片:我会用文生视频来探索场景、动作和风格。
- 我有想要的动作素材:我会考虑用视频生视频给它换一种观感。
然后我会根据视频发布的位置来选择构图。我希望从一开始就按手机屏幕来构图竖版社交片段。
在第一次生成时,我会保持运动简单。一个动作加一个运镜,能让我更清楚地判断需要调整什么。
如果是更长的序列,我还会规划场景顺序。在生成完整成片之前,我希望先明确开场是什么、如何推进想法、以及如何收尾。
第3步:先测试最关键的部分
我会先从最可能决定这个创意是否可行的镜头开始。
对产品视频来说,可能是一个必须让标签清晰可辨的特写。对社交片段来说,通常是开场。对概念来说,我想先看最能概括整个想法的场景。
我会根据目标来检查结果:
- 产品展示:产品是否仍然与照片一致?
- 社交视频:我能否立刻看懂开场?
- 概念探索:场景是否传达了预期氛围?
- 广告:信息是否清晰,包括下一步动作?
如果产品形变了,我会减少运动幅度或优化源图。如果开场节奏显得慢,我会调整时序或构图。
我会把提示词和设置与每个版本一起保存。这会让可用结果更容易继续迭代。
针对不同视频目标的四个示例
1.产品展示:让冰咖啡场景动起来
我先用了一张图:一杯冰咖啡放在黑色真皮汽车座椅上的抛光金属冰桶里。窗外能看到一位橙发女性。
我用图片生视频把这个设定做成了一个简短的产品故事。她先注意到咖啡,捡起一块石头,砸碎车窗,拿走了饮品。序列最后是她跑开,手里还拿着同一只杯子。
我把视频设为大约12秒,竖版构图。车窗场景里镜头保持在车内,然后在结尾加入了一个街道视角的跟拍镜头。
提示词:
将这张图片制作成一条12秒的竖版视频。固定机位放在复古汽车内,展示这位女性注视冰咖啡。她捡起一块石头,砸碎侧窗,从窗口伸手进去,将咖啡杯从金属冰桶中拿出。切到街道视角跟拍镜头,展示她拿着咖啡跑开。保持她的脸、橙色头发、穿搭,以及杯子设计和logo一致。让冰桶留在汽车座椅上。
| 输入图片 | 输出视频 |
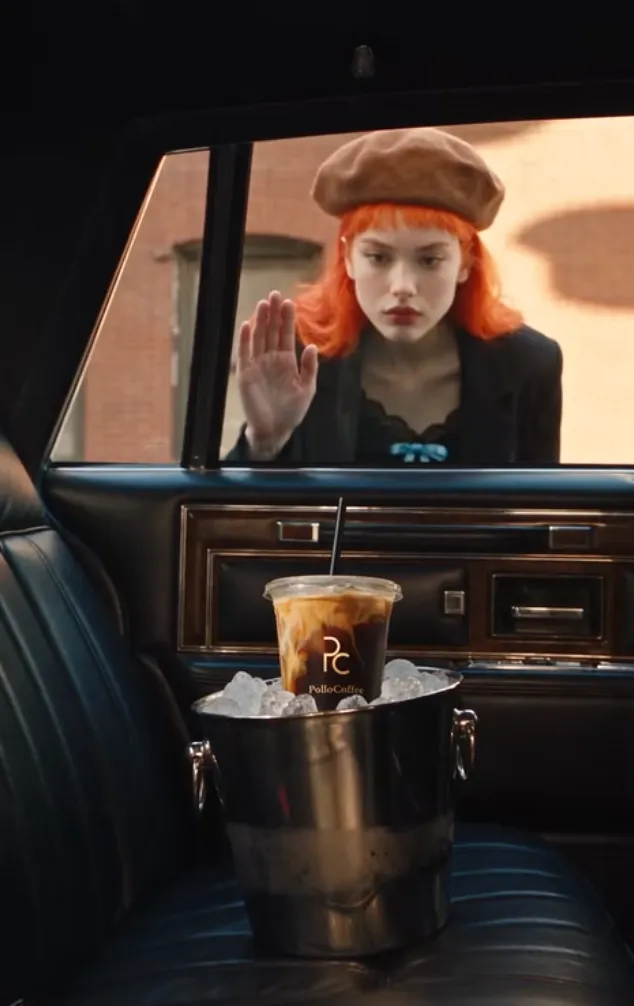 |
生成后,我检查了砸窗瞬间、她伸手拿杯子的动作,以及切到街道镜头的转场。我对比了她拿走咖啡前后咖啡的外观,以及她的脸、头发和穿搭。
咖啡让这个动作有了明确焦点。它在开场吸引了她的注意,并一直贯穿到最后一个镜头。对这次测试来说,保持这个产品可辨识性比增加更多运镜更重要。
2.社交视频:重构咖啡倒入片段风格
我选择了视频生视频,因为我已经拍到了所需动作。源素材是一段简短的竖版片段,画面中咖啡倒入杯中,机位稳定,液流清晰可见。
我把片段控制在约5秒,并选择了温暖的手绘风格。我的目标是在保留倒咖啡动作清晰度的同时,给素材一种不同的质感。
提示词:
将这段倒咖啡片段重构为温暖的手绘动画风格。保留倒入动作和构图。使用柔和的晨光,并保持统一的插画风格。
| 输入视频 | 输出视频 |
我重点查看了咖啡液流、杯口边缘以及握壶的手。这些细节让我能清楚判断风格是否在动作过程中保持一致。
我还在手机屏幕尺寸下观看了片段,并检查了前1秒。我希望倒咖啡动作能立刻可见,而不是先出现空镜头铺垫。
在这次测试中,我主要根据它把原始动作带入新风格的效果来评估这个工作流。
受众反馈是另一个需要发布数据来回答的问题。3. 概念探索:在云端之上创建一座图书馆
这个场景我从文生视频开始。我心里有一个设定,但没有一张图能准确呈现它:日出时分,一座巨大的图书馆漂浮在云层之上。
我把第一个镜头控制在大约五秒,并为这个AI 视频使用了宽屏构图。我想先建立空间感和氛围,再加入角色或对话。
提示词:
日出时分,一座巨大的图书馆漂浮在云层之上。几页松散的纸张在空中轻轻飘动。镜头在温暖、电影感的光线中缓慢向前推进。
输出视频:
我先检查了画面构图。我会看图书馆是否容易辨认、云层是否带来了高度感,以及镜头运动是否让空间关系清晰易懂。
我还检查了飘动的纸页会不会分散对建筑本身的注意力。图书馆是核心概念,所以我让周围动作尽量简洁。
我把这个当作一个由连贯场景组成的短篇故事的建立镜头。它让我能在规划重复出现的角色和准备后续镜头参考前,先评估场景设定。
4. 广告创意:通过Pollo 智能体制作短款水瓶营销活动
我为这个广告视频选择了视频智能体工作流,因为我需要多个场景来传达同一个信息。我先准备了一张清晰的水瓶照片,确认了产品信息,并写了一个简短的营销活动简报。
在开始生成之前,我规划了三个部分:开场文案、产品特写和结尾 CTA。我将整条视频控制在约 15 秒,并使用竖屏构图。
提示词:
根据这张水瓶照片制作一条 15 秒竖版广告。开头使用“Meet your daily desk companion,”,展示一个干净的产品特写,然后以“Shop now.”结尾。保持水瓶设计一致。添加背景音乐。
输出视频:
我先静音观看第一版,检查产品和信息在没有声音时是否也足够清晰。
然后我复查了文字出现时机,并对比了各场景中的水瓶。我特别关注它的瓶盖、比例和颜色。我还检查了结尾画面是否给了我足够时间阅读 CTA。
在这次测试中,我重点看广告结构和信息清晰度。我让产品主张始终基于已确认信息,把点击和销量留到真实营销活动测试中再看。
对比:哪种 AI 视频工作流更适合不同目标?
| 目标 | 我的起始素材 | 我的首选方案 | 我最重点检查的内容 |
| 产品展示 | 一张产品照片或已准备好的场景 | 图生视频 | 产品细节、构图和运动 |
| 社交视频 | 已有素材、图片或简短脚本 | 用于重塑风格的视频生视频;用于讲故事的序列工作流 | 开场、节奏和手机屏幕构图 |
| 概念探索 | 文字想法或氛围参考 | 文生视频 | 场景设定、氛围,以及想法是否传达出来 |
| 广告创意 | 产品素材、产品信息和简报 | 视频智能体工作流 | 信息表达、产品准确性、文字可读性和 CTA |
选择 AI 视频工作流前需要考虑的限制
产品细节可能会变化
一个杯子看起来可能很真实,但它的杯盖或标签会在镜头中发生变化。我会在整个视频中持续将这些细节与原图比对。
对于人物,我也会同样关注面部、手部和服装。仅看第一帧并不足够。
复杂动作需要更谨慎的规划
当人物伸手拿产品且镜头同时环绕拍摄时,会同时出现多个需要准确处理的点。
我会把复杂段落拆成更短的镜头。这样一来,如果某个片段效果不好,也更容易替换,而不用整条视频重做。
尽早检查导出选项
在制作完整视频前,我会先查看可用时长、宽高比、分辨率、格式和音频选项。
我也会在目标展示布局中预览结果。在大播放器里可读的字幕,到了手机上可能会太小。
为你保留的片段做预算
我会统计拿到可用镜头需要尝试多少次。相比单次生成价格,这能让我更实际地评估成本。
如果某个场景持续失败,我会先重新评估源素材、动作或工作流,再决定是否继续为类似尝试投入成本。
确认你可以上传和发布的内容
我会确认我有权限使用原始照片、视频素材、音乐、面孔和声音。
如果是客户项目,我还会在上传机密材料前查看该服务当前的商用和隐私条款。
常见问题
什么时候我该选择图生视频而不是文生视频?
当我已经有产品照片、人像或要动起来的场景时,我会选图生视频。文生视频更适合只有想法但没有起始图片的时候。
什么时候视频生视频是合适的工作流?
当现有素材已经具备我需要的动作和构图时,我会选择视频生视频。它让我在保证原始运动关系清晰的同时,探索不同的视觉风格。
如果 AI 改变了我产品的外观,我该怎么做?
我会使用更清晰的产品图、简化动作,并减少镜头角度变化。当必须展示精确产品特征或操作时,我会加入真实拍摄素材。
如何在多个 AI 视频场景中保持角色或产品一致?
我会复用相同的图片和描述,让角色和产品在各场景中保持可辨识。我会重点检查面部、服装、标志和比例,尤其是在剪辑切点处。
什么时候我该为 AI 视频选择智能体工作流?
对于需要多个连贯场景、文字和声音的广告、讲解或故事,我会选择智能体工作流。我的简报会明确受众、信息、场景顺序和结尾动作。
如何平衡 AI 视频的质量、速度和成本?
在生成完整视频前,我会先测试一个有代表性的镜头。我会比较每种工作流产出可用结果需要多少次尝试,包括修正细节所花的时间。