Gemini Omni AI 视频生成器
Gemini Omni 是 Google 的下一代多模态视频系列,用于创作、编辑和混剪。 立即在 Pollo AI 免费试用 Gemini Omni Flash(系列首款)!
探索 Gemini Omni 的无限可能
Gemini Omni 的预期功能
原生多模态视频生成 :在统一的创作工作流中,通过提示词、图像、片段、音频或模板创建视频。自然语言视频编辑 :通过简单的文本指令优化场景、动作、风格和细节。视频重混 :无需从零开始,把现有视频重新制作成全新版本。定向场景编辑 :在保留原始镜头、动作和风格的同时,修复视频中的特定部分。一致的视觉叙事 :在更长的视频序列中,保持角色、环境、风格和文字细节的一致性。基于知识的场景创作 :理解上下文、主题和含义,生成内部逻辑更强的场景。精准音频控制 :生成有意图、贴合场景的音频,与视频氛围和基调完美匹配。多样化镜头角度 :从多个视角捕捉动态电影镜头,带来更沉浸的体验。定制化数字人生成 :打造富有表现力的数字人,让你的数字分身鲜活起来。
原生多模态视频生成
Gemini Omni 不受限于单一输入类型。它能将不同参考信息理解为一条连贯的创作指令,让 AI 视频创作摆脱文生视频或图生视频这类狭窄格式。
你不再需要按格式拆分创意。用文本说明概念,用图像定义视觉风格,用片段建议动作,用音频引导整体基调。
Gemini Omni 会将这些信号整合在一起,帮你创作出更精准、更有表现力、也更贴合你想法的视频。
| 提示词 | 视频片段 | 输出 |
| 一条自然风格的 UGC 护肤广告,主角是一位年轻女性,拥有红棕色长发、明显雀斑和清新淡妆。她将绿色面霜罐靠近镜头展示,把面霜涂抹在脸上,并呈现清晰的前后肤质变化:从素颜有纹理的肌肤到更平滑、更柔软、带有光泽的状态。 |
自然语言视频编辑
Gemini Omni 让编辑变成对话。你不再需要调整时间轴、手动剪切场景,或从头重建片段。
你只需要输入修改内容,让模型来修订视频。借助这个功能,Gemini Omni 就像 Nano Banana,但它是一个 AI 视频生成器。
| 提示词 | 输入视频 | 输出视频 |
| 移除这个视频片段中 Sora2 的标志。 | ![]() | ![]() |
视频重混
有了 Gemini Omni,你可以基于已有视频继续创作,不用每次都重新开始。
你的片段可以在保留结构或创作方向的同时,变成新版本。这让迭代更快、更实用。
| 提示词 | 输入视频 | 输出视频 |
| 将“女孩在海边行走”的片段与产品片段结合,制作成电影感 TVC 风格广告,把生活方式美学镜头与精致产品画面融合,打造高级优雅的护肤商业广告。 |
定向场景编辑
Gemini Omni 支持在现有视频内进行精准编辑。你无需重生成整个场景,而是可以聚焦到需要改进的具体对象或细节。
通过这种实用的视频优化方式,你可以修正小问题,同时保持原始构图、动作和风格不变。
| 提示词 | 输入视频 | 输出视频 |
| 把两个人盘子里的意大利面都替换成奶油南瓜汤。其余内容保持不变。 |
一致的视觉叙事
Gemini Omni 有助于解决 AI 视频最难的问题之一:让每个场景都保持一致且有意义。它可以追踪角色身份、场景细节、视觉风格和环境元素,让每个镜头彼此连贯,而不是随机生成。
它在文本和公式连贯性方面的增强,也为更知识密集型视频打开了大门。比如在教授在黑板上书写公式的示例中,Gemini Omni 能同时较好地保留可读文本、逻辑符号和自然动作。
通过提升文本与公式连贯性,Gemini Omni 在课程、讲解视频、教程、产品演示、动画内容和品牌叙事中会更实用。
| 提示词 | 输出视频 |
| 一位教授在传统黑板上写出三角恒等式的数学证明,并讲解他当前进行到的等式步骤。 |
| 提示词 | 图像输入 | 视频输出 |
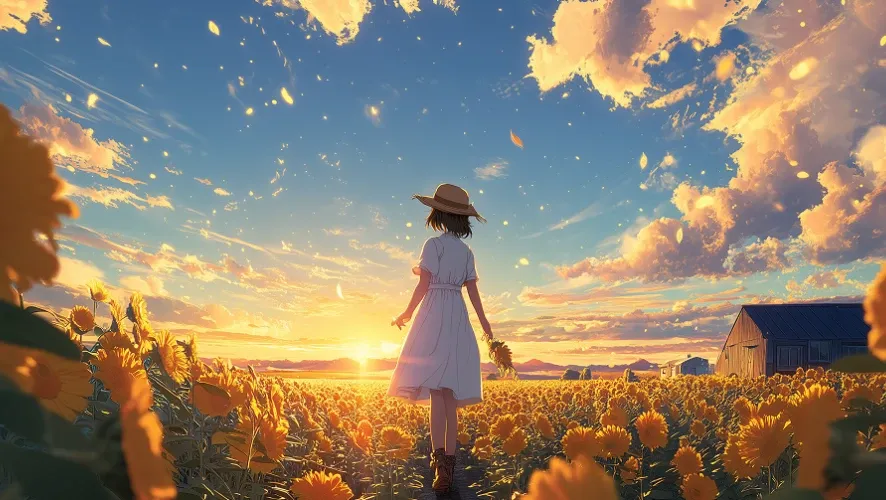
| 使用我上传的图像作为主要视觉参考,并在整个视频中保持场景高度一致。保留相同的动漫风乡村日落场景。在整段片段中维持完全一致的构图、角色设计、环境布局、光照方向、色彩方案和整体氛围。只添加细微自然动作:微风吹动裙子、头发和向日葵,空气中漂浮发光颗粒,以及缓慢的云层移动。保持镜头稳定,仅进行非常轻微的电影感推进。不要切换场景,不要重设计角色,不要变动物体,不要增加额外人物,不要改变布局。优先保证强场景一致性、视觉连续性以及对上传图像的还原度。 | ![]() | |
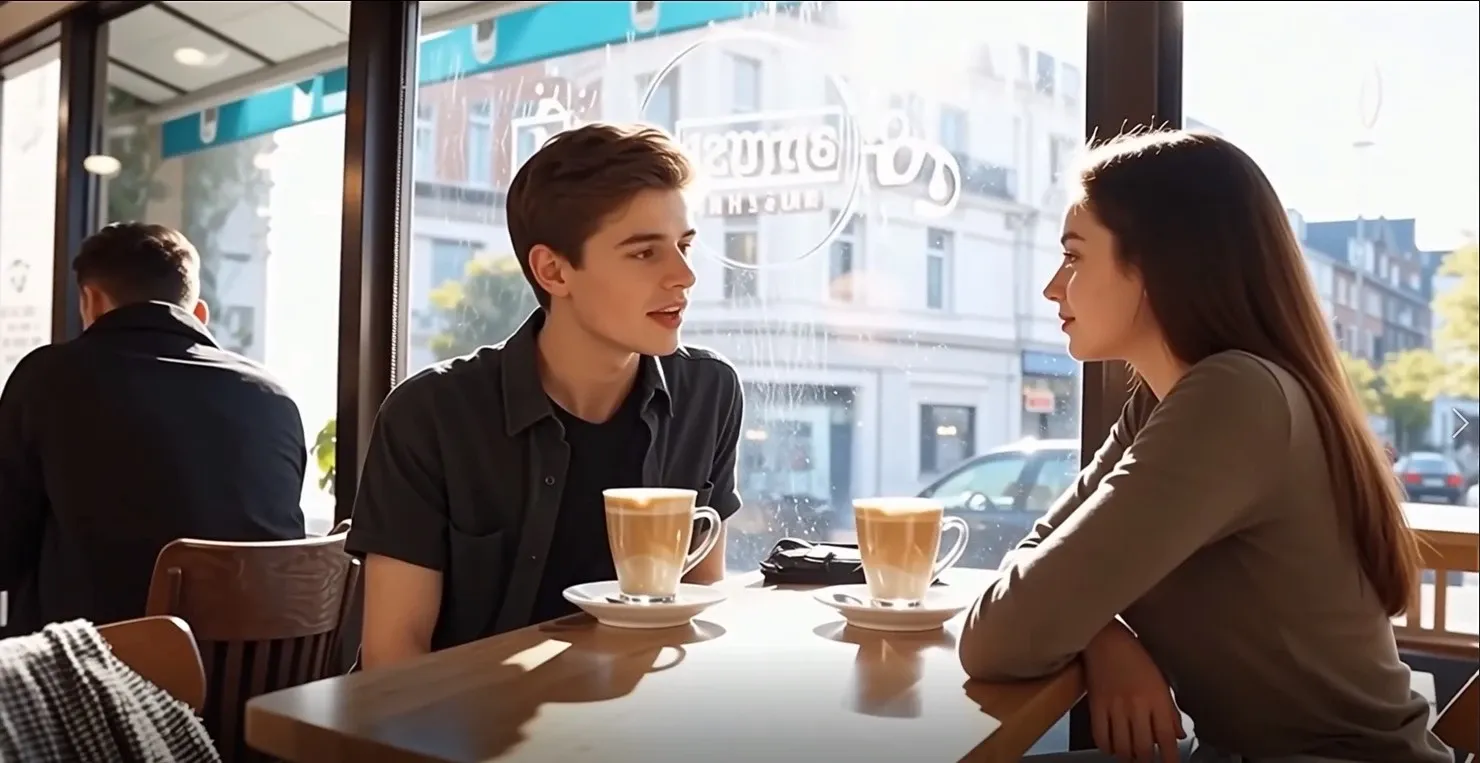
| 使用我上传的图像作为参考,创建一个高度一致的咖啡馆视频。保留相同的人物、桌子、咖啡杯、窗外景色、光线和构图。只添加细微的交谈动作,如眨眼、轻微头部移动、呼吸,以及窗外背景的少量动态。保持镜头稳定,避免任何重设计、布局变化或风格漂移。 | ![]() |
基于知识的场景创作
Gemini Omni 将 Google 更广泛的 AI 知识引入视频生成。它可以创建更有信息深度、结构更清晰、意义更明确的场景。
如果你想制作 历史场景、教育讲解视频 或产品演示,Gemini Omni 可以提供准确、逻辑清晰且直观的画面。
| 提示词 | 输出视频 |
| 制作一个关于史蒂夫·乔布斯人生故事的视频。 |
精准音频控制
Gemini Omni 通过实现不同镜头角度之间的无缝切换,重新定义了视觉叙事。
无论你需要戏剧性的俯拍镜头还是贴地视角,Gemini Omni 都能提供专业电影制作人依赖的电影级灵活性——把强大的多角度视频制作能力直接交到每位创作者手中。
对于教学设计师来说,你也可以使用 Gemini Omni 创建更清晰的培训材料,例如通过角度变化详细展示特定技巧的视频。
| 提示词 | 视频输出 |
| 一个写实电影镜头:一名黑人男子站在一张古老海图旁。他先指向海图,然后抬起头说:“根据这张古老海图,那座失落岛屿并非神话。我们必须立刻准备一次远征。”音频需有明确意图,并具备精准口型同步、清晰人声、细微室内环境声和轻微纸张摩擦声。整体氛围为戏剧化冒险风。 |
多样化镜头角度
Gemini Omni 通过实现不同镜头角度之间的无缝切换,重新定义了视觉叙事。
无论你需要戏剧性的俯拍镜头还是贴地视角,Gemini Omni 都能提供专业电影制作人依赖的电影级灵活性——把强大的多角度视频制作能力直接交到每位创作者手中。
对于教学设计师来说,你也可以使用 Gemini Omni 创建更清晰的培训材料,例如通过角度变化详细展示特定技巧的视频。
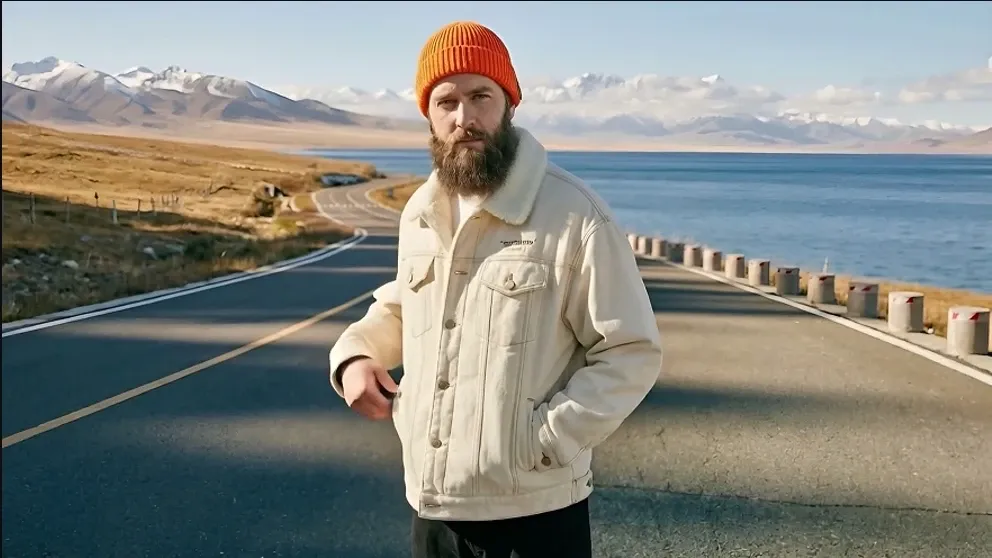
| 提示词:一个写实电影视频:一名留着浓密胡须、戴橙色针织帽、穿白色夹克的男子站在海岸公路上。他左侧是延伸到远方的开阔海面。画面开始时为男子在公路上静止站立的正面视角,海洋在其身侧可见。随后镜头切换为他的右侧侧脸视角,同时保持环境与人物外观一致。自然户外光线、真实动作、电影级构图、细节丰富的海岸氛围、平滑角度切换、高真实感。 | |
| 图像输入 | 视频输出 |
![]() | |
定制化数字人生成
你的数字形象完全由你掌控。Gemini Omni 提供深度自定义选项,助你打造富有表现力、逼真生动并能体现你个性与风格的数字人。
无论你是讲述者、教育者还是 VTuber,如果你想在保持现实身份匿名的同时吸引线上观众,Gemini Omni 的个性化数字人都是很好的解决方案。
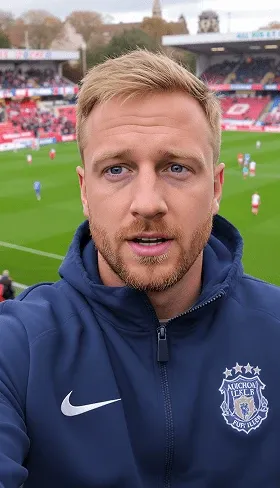
| 提示词:使用我上传的图像创建一个写实视频。保持我的脸部、发型和整体身份与参考图一致。我面向镜头直接说:“我在看台上感受着这股能量。你看到那记世界波了吗?”口型需与台词自然同步,并呈现真实面部表情和细微头部动作。 | |
| 图像输入 | 视频输出 |
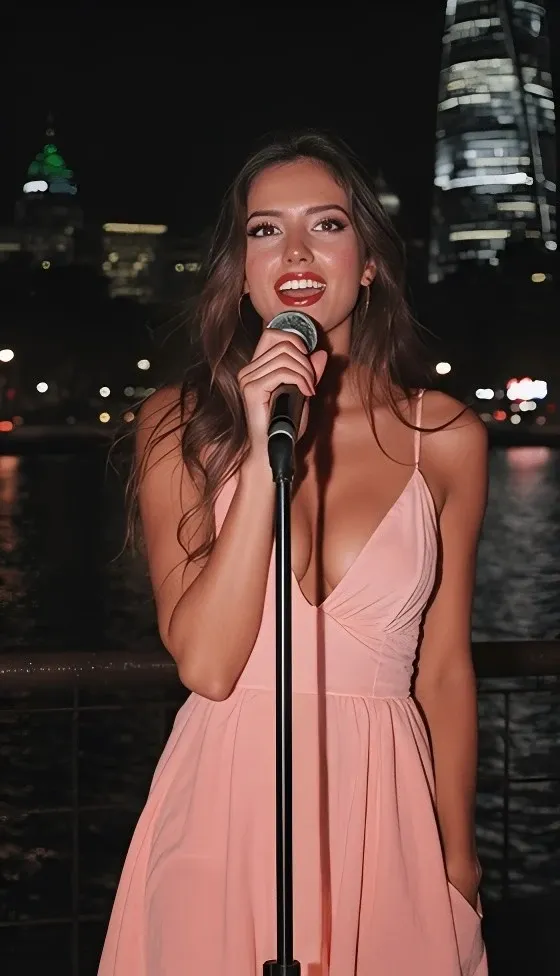
| 提示词:使用我上传的图像作为身份参考,生成一个电影感个性化数字人演唱视频。保持我的外观一致且真实。实现真实的演唱口型同步、富有情感的面部表情、细微的身体动作和自信的舞台表现力。重点关注美感、真实感和身份一致性。 | |
| 图像输入 | 视频输出 |
无论你的创意是什么,Gemini Omni 都能实现
作为先进的视频生成模型,Gemini Omni 正吸引来自各领域的更多用户。凭借强大功能,Gemini Omni 可适配不同需求,帮助提升销售和社交互动。
- 电影制作人和广告公司:制作原型、预演、专业级 TVC 广告 和 电影预告片。
- 内容创作者:生成高质量、吸引人的视频(Reels、Shorts、TikToks),并保持角色一致和音频表现力。
- 营销人员:简化 宣传视频 与产品可视化制作,打造品牌内容。
- 教育工作者:制作有吸引力的讲解视频、培训视频 和教育内容,把复杂概念转化为可视化叙事。
- 机构与工作室:使用专业工作流实现广播级输出、一致渲染和精准创意控制。
Gemini Omni:相比 Veo 3 的一次飞跃
Gemini Omni 展示了自 Veo 3 以来 Google 的 AI 视频技术进步了多少。凭借更强的整体体验和更成熟的输出,它帮助创作者从简单试验走向更严肃、更具创意的视频制作。
| 功能 | Veo 3 | Gemini Omni |
| 输入 | 文本和图像提示词 | 提示词、参考素材、片段和模板 |
| 视频时长 | 短片段,通常约 8 秒 | 更长片段,预计约 15–30 秒,节奏更顺滑,过渡更自然 |
| 场景一致性 | 帧间一致性有限 | 整段场景具备更强时间一致性,对象持续性更好,多角色互动更稳定 |
| 镜头控制 | 基础的提示词驱动镜头运动 | 对镜头焦段、运动、构图和节奏有更精确控制 |
| 多角度场景 | 不支持 | 支持通过单一提示词为每个场景生成多个镜头角度 |
| 个性化数字人 | 不可用 | 个性化数字人,支持语音同步、准确面部表情和口型同步 |
| 编辑工作流 | 修改需重生成整段片段 | 生成过程中可交互编辑,支持中途调整 |
| 主要使用场景 | 生成短篇实验视频 | 面向生产可用的视频创作工作流 |
| 分辨率 | 最高 1080p 输出 | 最高 4K 输出 |
| 音频 | 静音视频或基础音频(用于时间参考) | 更高质量、有明确意图的音频,语音更有表现力,节奏更好,环境声更丰富,声音设计更连贯 |
| 多语言准确性 | 基础 | 屏幕文字、标识、UI 渲染更准确,不同语言下口型同步更自然 |
想了解完整洞察,请查看我们的 Gemini Omni 评测。
如何在 Pollo AI 上使用 Gemini Omni
选择 Gemini Omni 模型
打开图像转视频页面并选择 Gemini Omni 模型(即将推出)。
输入你的提示词
上传你的图片,如有需要可输入提示词,然后调整视频设置。
下载结果
点击“创建”生成你的视频,然后下载。
探索其他 Gemini Omni 模型

10M+用户
使用 Pollo AI 进行创作与激发灵感
超过1000万创作者和营销人员使用
常见问题解答
什么是 Gemini Omni?
Gemini Omni 是 Google 原生的多模态 AI 视频模型,用于创建和编辑视频。它旨在让视频生成更具对话性。Gemini Omni 凭借视频混剪、一致的视觉叙事以及具备世界知识感知的生成等高级功能,成为 AI 视频创作的一次重大飞跃。
Gemini Omni 与其前代 Veo 3 有何不同?
Gemini Omni 相比 Veo 3 有显著提升,具备更高分辨率(最高可达 4K)、更长的视频时长,以及更快的生成速度。它在角色和物体的一致性方面表现更佳,提供更精准的电影级控制,以及更先进的集成音频能力,包括更好的唇形同步和多语言准确性。
Gemini Omni 在 Pollo AI 上可以免费使用吗?
是的!当 Gemini Omni 在我们的网站上线后,你可以在 Pollo AI 免费试用。Pollo AI 提供试用,让你可以探索其强大的视频生成功能。
Gemini Omni 适合初学者吗?
是的!Gemini Omni 对新手很友好。它的界面简单,不需要拍摄设备或剪辑技能。你只需输入描述,它就会立即生成视频。虽然掌握高级功能需要练习,但上手很直接,让所有人都能轻松使用,不受经验水平限制。
Gemini Omni 中的有意音频功能是如何工作的?
Gemini Omni 的意图性音频可生成具备上下文感知的声音体验,包括带口型同步的富有表现力的对话、基于物理的 Foley 音效、沉浸式环境声场,以及原创配乐。所有音频都经过空间定位,并在镜头切换间连贯衔接,省去大量后期制作。
立即在 Pollo AI 上试用 Gemini Omni!
使用 Gemini Omni,通过视觉素材或自然语言指令来创建、编辑和混剪细致视频。