LumeFlow AI 评测:我测试了它的动态工具
LumeFlow AI 是一个多模型创意平台,它的视频功能让用户可以从文本或图像生成内容、从参考片段模仿动作、延展视频素材、添加特效并应用唇形同步。
让我想测试它的原因是,它提供了多种让一个想法“动起来”的方式;我想看看这些路径能否组成完整的视频工作流,还是仅仅停留在强大的单素材转换。
我的结论:LumeFlow AI 在短视频动态创作沙盒方面最有说服力;当任务需要多个场景、叙事顺序和可直接发布的结构时,它就没那么直接了。
LumeFlow AI 评测:TL;DR
| 领域 | 我的看法 |
|---|---|
| 类别 | 多模型 AI 视频与动态平台 |
| 核心输入 | 文本、静态图像、源视频或参考动作 |
| 关键机制 | 文本/图像生成、动作模仿、视频延展、特效、唇形同步 |
| 输出形态 | 短时长的生成、动画化或转换后片段 |
| 更好的替代方案 | Pollo AI用于多场景草稿和明确的发布任务 |
什么是 LumeFlow AI?
LumeFlow AI是一个网页平台,为创作者提供多个视频模型,以及用于动作、延展、特效和唇形同步的专用工具。
它的AI 视频生成路径可从文本或图像开始,而动作模仿则从静态主体和参考动作片段开始。视频生视频工具可接收现有素材进行延展或转换,因此这个平台是围绕创作者已拥有的源素材来组织的。
该产品还展示了会变化的模型目录和提示词智能体,但用户仍需自行选择输入路径和工具。因此,LumeFlow 的表现更像一个动态工作台,而不是单一的引导式编辑器。
我是如何评估 LumeFlow AI 的
我通过四种来源路径评估了 LumeFlow AI:文字场景、静态图像、静态主体+参考动作,以及现有视频。对每条路径,我都会检查源素材能控制什么,以及生成器仍可自由发挥什么。
我特别关注了动作模仿,因为它的参考动作工作流比通用提示词更具体:主体图像决定“谁”会出现,而上传的动作片段决定该主体“如何”移动。
核心功能评测
文本和图像起步
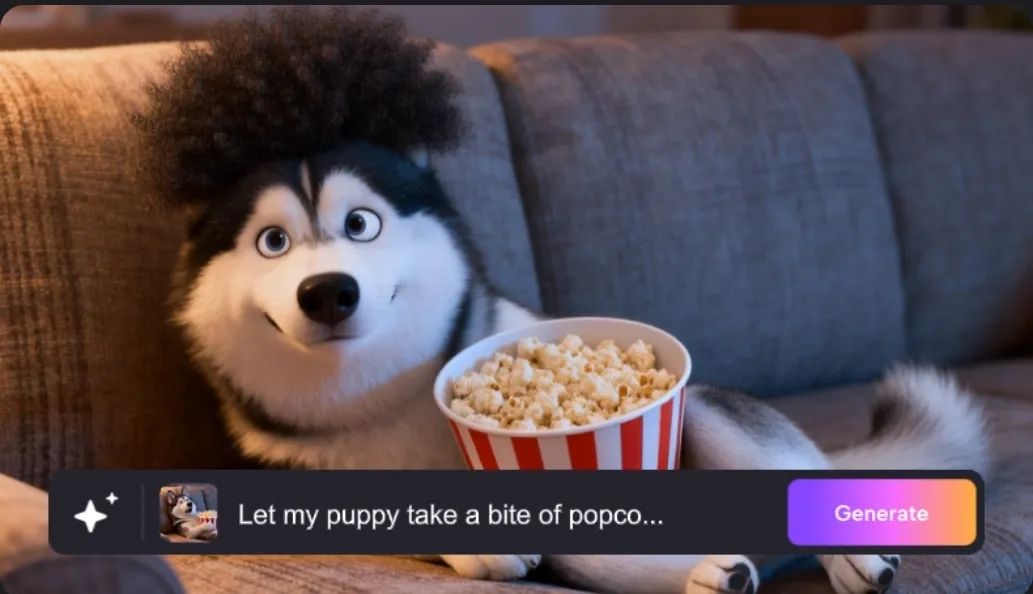
LumeFlow 的文本路径需要输入提示词和视频参数,而图像路径会把一张静态图与动作指令结合。这让用户可以在“创造新场景”和“保留现有构图”之间做出清晰选择。
简单的文本生成视频场景适合探索氛围和运动,而图像生成视频在主体已经足够理想时更稳妥。当提示词要求多个定时动作、精确的产品摆放,或镜头间连续性时,这两条路径都会变得脆弱。
动作模仿
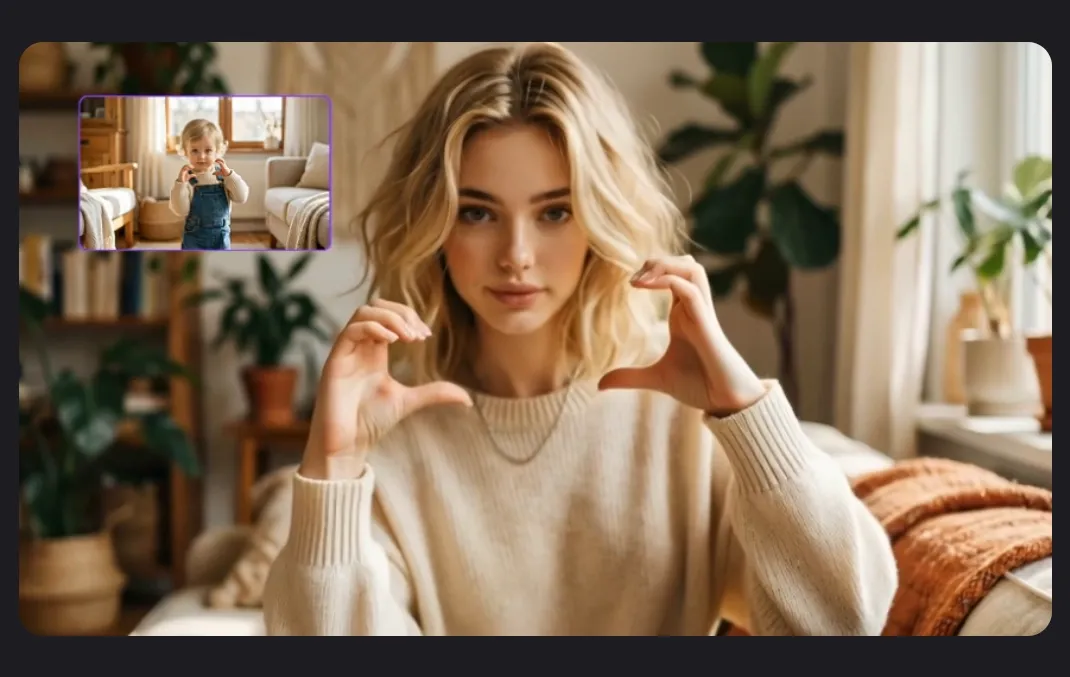
动作模仿使用两个明确输入:JPG、JPEG 或 PNG 主体图像,以及 MP4 动作参考。当前界面要求图像至少为 480×480 像素,并将动作参考限制为 30 秒。
当我更容易“展示动作”而不是“描述动作”时,我会优先使用 LumeFlow 的这个功能。参考片段减少了一部分猜测成本,但它无法挽救质量差的主体图像、被遮挡的肢体,或与表演者映射不佳的体型。
视频延展与转换
LumeFlow 的视频生视频支持接收最高 50 MB、1920px、30 秒以内的 MP4 或 MOV 素材,然后用提示词对片段进行延展或转换。以真实素材为起点,比从静态图中凭空生成动作能保留更多时序信息。
这让视频生视频在续接与风格实验上很有用。但当人脸、产品标签、服装或镜头路径必须完全准确时,它就没那么稳妥,因为视觉转换可能会改变源素材原本要保护的那些细节。
特效与唇形同步
特效提供快速转换,而唇形同步能为现有人脸或片段加入口语化表演。这些路径很适合社交内容创意,因为它们从可见动作出发,而不是从冗长的制作需求说明开始。
用户仍需判断特效是否服务于想法,以及唇形同步结果在近景下是否自然。
技术上同步的嘴型无法弥补平淡的表达、薄弱的构图,或在效果落地后没有继续理由的片段。
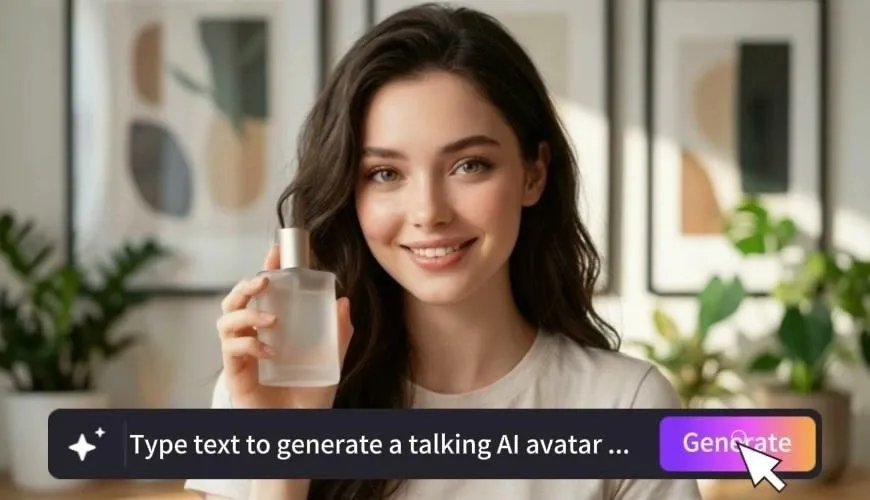
这个对口型演示从一张人像和输入的语音文本开始。
LumeFlow AI 使用场景:谁适合用它?
LumeFlow AI 适合那些已经有初步想法,并且需要快速测试其运动效果的创作者。
- 参考动作表演:用于将舞蹈、手势或身体动作迁移到静态主体上的创作者。
- 静态图片动画:用于艺术家和社媒团队判断一个构图是否能支撑一个短片段。
- 效果驱动的社交媒体帖子:用于把视觉变换作为TikTok 视频吸引点的用户测试。
- 宣传氛围测试:用于团队在脚本和镜头清单确定之前先制作一个短宣传视频。
我喜欢的地方
我喜欢 LumeFlow 围绕用户已有内容来组织视频决策。先选择文本、图片、视频或动作参考,再决定模型名称,这比在未定义来源前先选模型更有用。
上传指引也让边界更清晰。文件类型、大小、分辨率和时长限制,比“任何媒体都能用”这种模糊承诺更容易规划。
LumeFlow AI 的不足之处
尴尬的时刻出现在某个片段终于可用之后。模仿动作、延长镜头或视觉效果单看都可能不错,但我仍会追问:视频开头是什么、下一个镜头补充了什么、以及这个想法如何收尾。
- 参考动作会迁移动作,但不会迁移意图:一个手势可以被精确复制,但对角色、产品或信息来说依然可能不合适。
- 素材限制会塑造创意:当前动作和视频路径对文件、分辨率和时长设有限制,可能排除更长或更大的素材。
- 变换可能覆盖关键细节:即使视觉效果成功,如果身份或产品细节发生漂移,仍可能需要视频增强或重新生成。
优缺点
优点:
- 清晰的来源导向视频路径
- 明确的图片+动作工作流
- 实用的延展和变换选项
- 效果和对口型支持快速试验
缺点:
- 每条路径只解决一个片段级任务
- 主体和参考必须能精确匹配
- 重要的源素材细节可能漂移
- 吸睛效果无法提供故事结构
超越 LumeFlow AI
当我还在尝试让某一张图片、某个动作或某个效果成立时,我会继续留在 LumeFlow。一旦这个片段变成可保留版本,我的问题就会从“我能让它动起来吗?”变成“我怎么把它做成一个有开头、承接节奏和结尾的视频?”
这时我会打开 Pollo AI,一个更全面的 AI 创作套件。除了生成或修正单个片段之外,Pollo Agent 还能接收想法或源素材,编排多个场景,并给我一条可完整审看的序列,而不是同一镜头的另一个变体。
- 多场景初稿:Pollo 智能体可以把一个想法或素材组织成完整序列,让用户一起审看场景与节奏。
- 定向片段修正:Pollo AI 的AI 视频编辑器支持上传源片段并通过文本指令进行修改,例如移除物体、更换背景或视觉风格重塑。
- 叙事路径:Pollo AI 的故事视频生成器会为故事导向的想法提供明确的开端、推进和结尾,而不是把每个镜头当作孤立实验。
最终结论
我觉得最有用的是 LumeFlow 以输入为先的逻辑。创作者可以先判断这个想法存在于提示词、静态图片、动作参考还是现有片段中,再决定如何生成。
如果你要围绕单个素材做动作迁移、图片动画、短变换和效果测试,就用 LumeFlow AI。如果那个成功的片段需要放进多场景故事、接收基于提示词的修正,或变成可交付的完整内容形式,就用 Pollo AI。