LumeFlow AI 評測:我實測了它的動態工具
LumeFlow AI 是一個多模型創意平台,其影片端讓使用者能從文字或圖像生成內容、從參考片段模仿動作、延展影片、加入特效,並套用唇形同步。
讓我想測試它的原因,是它提供了許多讓同一個想法動起來的方法;我想看看這些路徑能不能組成完整的影片工作流程,還是只是各自強大的單一素材轉換。
我的結論:LumeFlow AI 作為短影音動態沙盒最有說服力;但當任務需要多個場景、敘事順序與可直接發布的結構時,它就沒那麼直接。
LumeFlow AI 評測:TL;DR
| 領域 | 我的看法 |
|---|---|
| 類別 | 多模型 AI 影片與動態平台 |
| 核心輸入 | 文字、靜態圖像、來源影片或參考動作 |
| 關鍵機制 | 文字/圖像生成、模仿動作、影片延展、特效、唇形同步 |
| 輸出形態 | 短片生成、動畫化或轉換後片段 |
| 更好的替代方案 | Pollo AI用於多場景草稿與明確的發布任務 |
什麼是 LumeFlow AI?
LumeFlow AI是一個網頁平台,讓創作者可以使用多種影片模型,以及專注於動作、延展、特效與唇形同步的工具。
它的AI 影片生成路徑可從文字或圖像開始,而模仿動作則從靜態主體與參考動作片段開始。影片轉影片工具可接收既有素材做延展或轉換,因此平台是圍繞創作者手上已有的來源素材來組織的。
這個產品也提供會變動的模型目錄與提示詞智能體,但使用者仍需自行選擇輸入路徑與工具。因此,LumeFlow 的行為更像是一個動態工作台,而不是單一的引導式編輯器。
我是如何評估 LumeFlow AI 的
我依照四種來源路徑評估 LumeFlow AI:一段文字場景、一張靜態圖像、一個靜態主體加參考動作,以及一段既有影片。對每條路徑,我都檢查來源能控制什麼,以及生成器仍可自由創造什麼。
我特別關注模仿動作,因為它的參考動作工作流程比一般提示詞更具體:主體圖像定義誰會出現,而上傳的動作片段定義該主體應該如何移動。
核心功能評測
文字與圖像起始
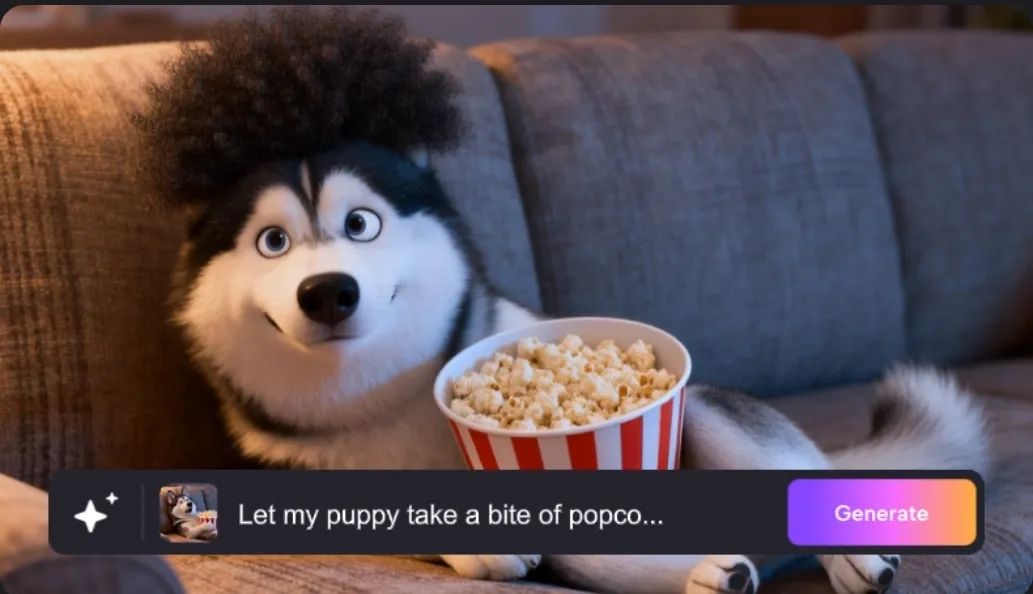
LumeFlow 的文字路徑會要求提示詞與影片參數,而圖像路徑則把一張靜態圖像與動作指令結合。這讓使用者能清楚選擇:要創造新場景,或保留既有構圖。
簡單的文字轉影片場景有助於探索氛圍與動態,而圖像轉影片在主體外觀已經正確時更安全。當提示詞要求多個定時動作、精準的產品擺放,或跨鏡頭連貫性時,兩條路徑都會變得脆弱。
模仿動作
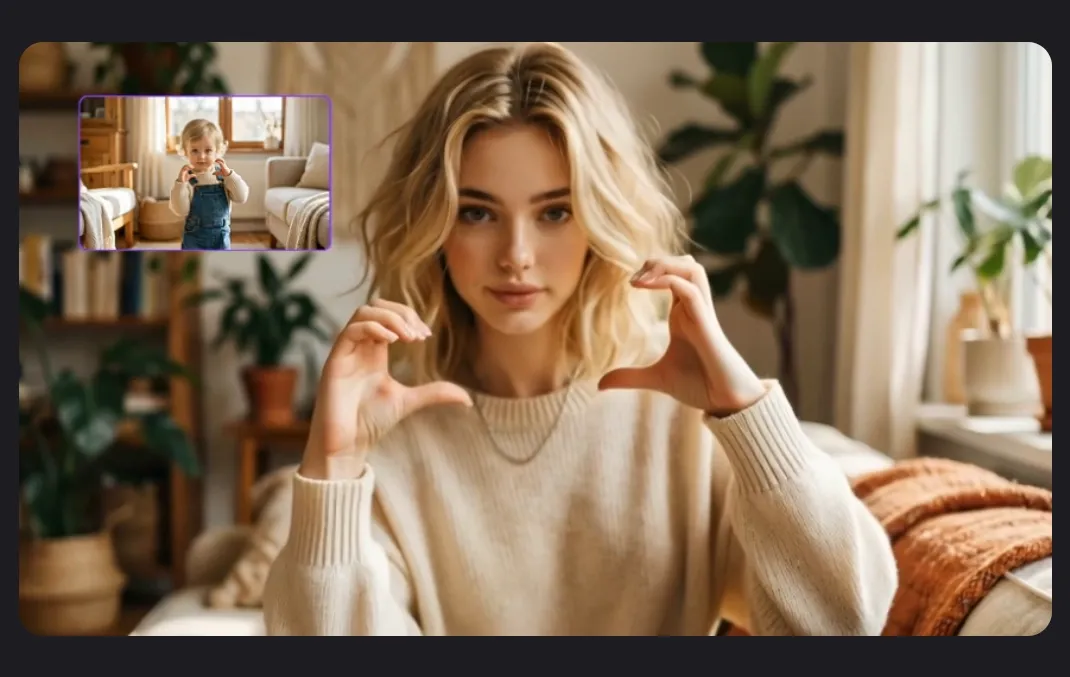
模仿動作使用兩個明確輸入:JPG、JPEG 或 PNG 主體圖像,以及 MP4 動作參考。現行介面要求圖像至少為 480 x 480 像素,且將動作參考限制在 30 秒內。
這是 LumeFlow 中我會在「我比起描述更容易展示動作」時優先使用的功能。參考片段可減少部分猜測,但無法補救品質差的主體圖像、被遮擋的肢體,或與表演者對應不佳的身形。
影片延展與轉換
LumeFlow 的影片轉影片支援可接受最多 50 MB、1920px、30 秒的 MP4 或 MOV 素材,接著使用提示詞延展或轉換片段。從真實素材開始,比從靜態圖像憑空生成動態更能保留時序資訊。
這使影片轉影片在續接與風格實驗上很實用。但當臉部、產品標籤、服裝或鏡頭路徑必須精準一致時,它就比較不安全,因為視覺轉換可能會改掉來源本來要保留的細節。
特效與唇形同步
特效可提供快速轉換,而唇形同步可為既有臉部或片段加入口語表演。這些路徑對社群內容點子很實用,因為它們是從可見動作開始,而不是從冗長的製作需求開始。
使用者仍需要判斷該特效是否支撐想法,以及唇形同步結果在近距離觀看時是否自然。
技術上同步的嘴型,無法彌補平淡的演繹、薄弱的構圖,或是在效果出現後沒有理由繼續下去的片段。
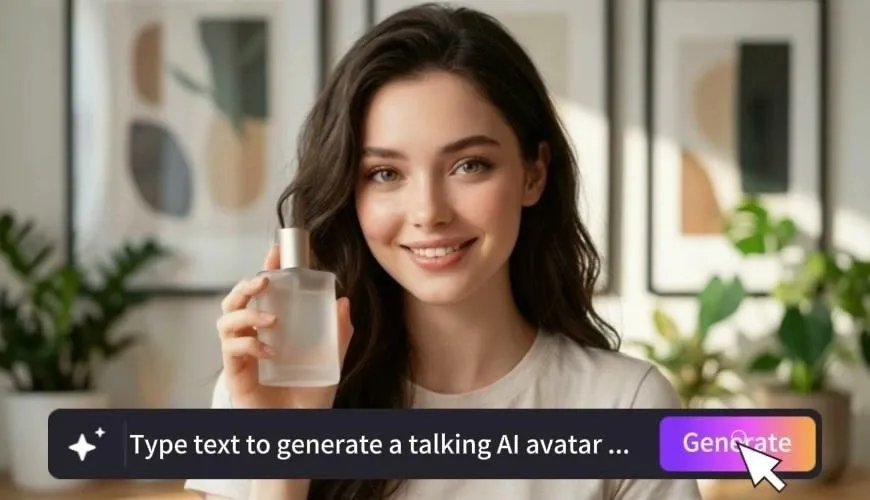
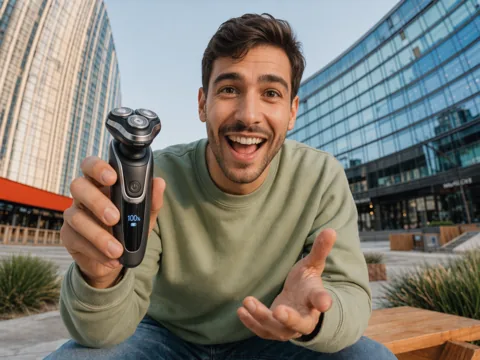
這個嘴型同步示範是從一張人像和輸入的語音文字開始。
LumeFlow AI 使用情境:誰適合使用?
LumeFlow AI 適合那些已經有原始想法、並且需要快速測試動態效果的創作者。
- 參考動作表演:適合把舞蹈、手勢或身體動作轉移到靜態主體上的創作者。
- 靜態圖像動畫:適合藝術家與社群團隊檢查單一構圖是否能支撐一段短片。
- 效果導向社群貼文:適合把視覺轉換當作亮點來測試TikTok 影片的使用者。
- 宣傳氛圍測試:適合在腳本與鏡位清單定案前,先製作短宣傳影片的團隊。
我喜歡的地方
我喜歡 LumeFlow 會把影片決策建立在使用者已經擁有的素材上。先選文字、圖像、影片或動作參考,再決定模型,這比在來源尚未定義前就先選模型名稱更實用。
上傳指引也讓限制條件更清楚可見。檔案類型、大小、解析度與時長限制,比起含糊地承諾任何媒體都可用,更容易規劃。
LumeFlow AI 的不足之處
尷尬的時刻通常出現在某支片段終於可用之後。模仿動作、延長鏡頭或特效本身可能看起來不錯,但我仍可能會問:影片開頭是什麼、下一個鏡頭補充了什麼,以及這個想法要怎麼收尾。
- 參考動作只轉移動作,不轉移意圖:一個手勢可以被精準複製,但對角色、產品或訊息來說仍可能不對味。
- 來源限制會塑造想法:目前的動作與影片路線有檔案、解析度與時長邊界,可能排除較長或較大的素材。
- 轉換可能覆蓋關鍵細節:即使視覺特效成功,若身份與產品細節出現偏移,仍可能需要影片增強或重新生成。
優缺點
優點:
- 清楚、以來源為核心的影片製作路線
- 明確的圖像加動作工作流程
- 實用的延展與轉換選項
- 特效與嘴型同步支援快速實驗
缺點:
- 每條路線只解決單一片段層級任務
- 主體與參考內容必須精準對應
- 重要來源細節可能漂移
- 亮點特效無法提供故事結構
不只 LumeFlow AI
當我還在嘗試讓單一圖像、動作或特效成立時,我會待在 LumeFlow。一旦那支片段成為可保留版本,我的問題就會從「我能讓它動起來嗎?」變成「我要怎麼把它變成有開頭、承接節奏與結尾的影片?」
這時我會開啟 Pollo AI,一個更全面的 AI 創作套件。除了生成或修正單一片段之外,Pollo Agent 還能接手這個想法或來源素材,安排多個場景,給我一段完整序列可供檢視,而不是同一鏡頭的另一個變體。
- 多場景初稿:Pollo Agent可以把想法或素材整理成完成序列,讓使用者同時檢視場景與節奏。
- 精準片段修正:Pollo AI 的 AI 影片編輯器可接受來源片段與文字指令,進行物件移除、背景替換或視覺風格重塑等修改。
- 敘事路線:Pollo AI 的故事影片生成器能讓故事導向的想法擁有明確的開端、發展與結尾,而不是把每個鏡頭當成孤立實驗。
最終評價
我覺得最實用的是 LumeFlow 的「輸入優先」邏輯。創作者可以先判斷想法存在於提示詞、靜態圖像、動作參考,或既有片段中,再決定如何生成。
如果你要針對單一素材做動作轉移、圖像動畫、短片轉換與特效測試,就用 LumeFlow AI。當那支成功片段需要放進多場景故事、接受提示詞修正,或變成完整內容格式時,就用 Pollo AI。